





Theo ArsTechnica, Brent Hecht - Giám đốc Khoa học ứng dụng tại Microsoft, từng đưa ra những nhận xét mạnh về cách các công ty AI thu thập nội dung trên internet để huấn luyện mô hình. Các phát biểu được đề cập trong hồ sơ liên quan vụ kiện bản quyền giữa Microsoft, OpenAI và nhóm tổ chức báo chí do The New York Times dẫn đầu.
Hecht mô tả việc thu thập nội dung báo chí để huấn luyện AI là hành vi lấy đi lượng công sức ở quy mô chưa từng có. Ông cũng cho rằng cách thu thập dữ liệu rộng rãi này khó phù hợp với lập luận "sử dụng hợp lý" (fair use) mà Microsoft và OpenAI đưa ra trong tranh chấp bản quyền.
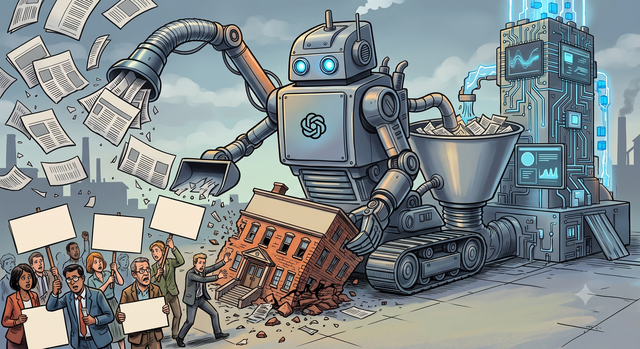
AI thu thập lượng lớn nội dung trên internet đang làm gia tăng tranh luận về bản quyền và quyền lợi của người sáng tạo
ẢNH: TẠO BỞI AI
Hecht còn lưu ý phần lớn những người tạo nội dung không có ý định để sản phẩm của họ được sử dụng theo cách này, đồng thời không nhận được thù lao tương ứng.
Tuy nhiên, Microsoft cho biết những nhận xét trên chỉ phản ánh quan điểm cá nhân của một nhân viên, không phải phân tích pháp lý và không đại diện cho quan điểm của công ty. Microsoft bảo vệ các sản phẩm AI của mình, cho rằng việc sử dụng nội dung mang tính chuyển đổi và không thay thế các trang tin.
Tranh chấp hiện tập trung vào câu hỏi liệu việc sao chép nội dung để huấn luyện AI và cung cấp câu trả lời cho người dùng có thuộc phạm vi sử dụng hợp lý theo luật bản quyền hay không. Các hãng tin cho rằng chatbot có thể tái tạo một phần nội dung và thay thế nhu cầu truy cập nguồn gốc.
Lo ngại AI làm suy yếu nguồn nội dung trên internet
Một vấn đề khác được nêu là tác động của chatbot đến lưu lượng truy cập các trang báo. Satya Nadella, CEO Microsoft, thừa nhận chatbot có thể khiến người dùng không cần truy cập nguồn ban đầu vì thông tin đã xuất hiện trực tiếp trên nền tảng AI.
Theo dữ liệu được viện dẫn trong hồ sơ, Microsoft ghi nhận tỷ lệ nhấp vào nguồn giảm 83 - 93% đối với một số trường hợp và 51 - 94% với những trường hợp khác. Phía các hãng tin sử dụng số liệu này để lập luận rằng sản phẩm AI đang thay thế một phần hoạt động của các trang báo.
Các trao đổi nội bộ tại OpenAI cũng đề cập nguy cơ tương tự. Nick Turley - lãnh đạo phụ trách ChatGPT, từng nhận định các sản phẩm thương mại được huấn luyện bằng nội dung báo chí có thể tạo ra mối đe dọa đối với các nhà xuất bản khi chúng trở thành phương án thay thế nguồn tin.
Một tài liệu của Microsoft còn mô tả nguy cơ hình thành vòng lặp: AI làm giảm lưu lượng và nguồn thu của các đơn vị sản xuất nội dung, khiến nguồn thông tin chất lượng suy yếu, trong khi chính các mô hình AI lại phụ thuộc vào nguồn dữ liệu này để duy trì chất lượng.
Tranh luận này hiện là một phần của cuộc chiến pháp lý rộng hơn về cách Microsoft và OpenAI sử dụng nội dung có bản quyền. Các hãng tin muốn tòa án xác định rõ giới hạn sử dụng nội dung báo chí cho AI, trong khi Microsoft tiếp tục bảo vệ lập luận rằng sản phẩm của hãng không thay thế các nguồn tin gốc.
Bình luận (0)