





Theo Wccftech, Beam là mô hình AI mới do Reflection AI giới thiệu, có tổng cộng 501 tỉ tham số và hướng đến các tác vụ lập trình, suy luận cũng như vận hành tác nhân AI. Đây là mô hình open-weight (công khai trọng số), cho phép nhà phát triển tải về, triển khai hoặc tiếp tục tinh chỉnh theo nhu cầu.
Dù sở hữu hơn 500 tỉ tham số, Beam chỉ kích hoạt khoảng 23 tỉ tham số tại một thời điểm. Điều này đến từ kiến trúc Mixture-of-Experts - MoE (hỗn hợp chuyên gia), trong đó hệ thống gồm nhiều nhóm tham số chuyên biệt nhưng chỉ lựa chọn một số nhóm phù hợp để xử lý mỗi yêu cầu.
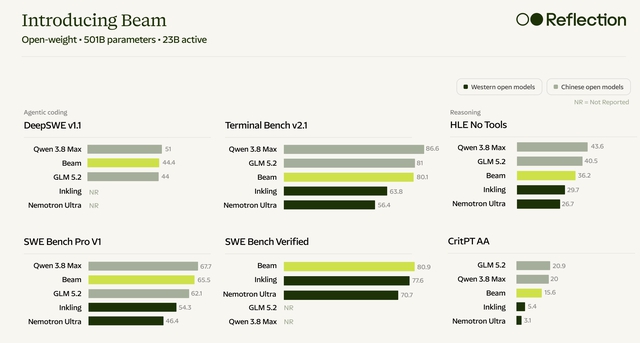
Beam cho thấy hiệu năng cạnh tranh với Qwen 3.8 Max, GLM 5.2, Inkling và Nemotron Ultra trên nhiều bài kiểm tra lập trình, suy luận do hãng công bố
ẢNH: REFLECTION
Cách vận hành này giúp giảm lượng tính toán cần thiết so với việc huy động toàn bộ 501 tỉ tham số cho mọi tác vụ. Reflection cho biết Beam tập trung vào lập trình, suy luận và các tác vụ do tác nhân AI tự thực hiện theo nhiều bước.
Trước giai đoạn hoàn thiện, Beam được pretraining (tiền huấn luyện) trên 23.800 tỉ token, tức các đơn vị dữ liệu nhỏ mà mô hình sử dụng để học. Quá trình tiền huấn luyện từ đầu được thực hiện trong chưa đầy bốn tuần trên cụm 6.144 card đồ họa (GPU) Nvidia GB300 NVL72.
10.500 card đồ họa được dùng cho giai đoạn học tăng cường
Quy mô còn lớn hơn ở giai đoạn reinforcement learning - RL (học tăng cường), phương pháp cho phép AI thử thực hiện nhiệm vụ, nhận kết quả đánh giá rồi điều chỉnh cách xử lý. Reflection cho biết đã sử dụng 10.500 GPU Nvidia GB300 liên tục trong bốn tuần cho quá trình này.
Hệ thống tạo hơn 100 triệu chuỗi tương tác thử nghiệm của AI với môi trường và sử dụng khoảng 1,3 tỉ sandbox (môi trường thực thi cô lập). Sandbox cho phép mô hình thực hiện những tác vụ như chạy mã hoặc sử dụng công cụ trong không gian riêng, hạn chế tác động đến hệ thống bên ngoài. Quy mô này tương đương hàng chục triệu lượt tạo sandbox mỗi ngày.
Reflection còn xây dựng khoảng một triệu môi trường dành cho lập trình, tác nhân AI và STEM. Trong quá trình huấn luyện, hệ thống có thể duy trì trung bình khoảng 110.000 rollout đồng thời và hỗ trợ tới 170.000 sandbox hoạt động cùng lúc.
Theo kết quả do Reflection công bố, Beam đạt điểm suy luận tương đương GLM-5.2 ở một số phép thử nhưng sử dụng lượng inference compute (tài nguyên tính toán khi mô hình tạo câu trả lời) thấp hơn khoảng 3-4 lần. Đây là phép ước tính dựa trên số tham số hoạt động và lượng token tạo ra, không phải đo trực tiếp toàn bộ chi phí vận hành thực tế.
Beam hiện vẫn trong quá trình kiểm thử nhằm tìm điểm yếu và rủi ro cùng các bước đánh giá cuối. Reflection dự kiến công bố đầy đủ trọng số, báo cáo kỹ thuật và tài liệu mô tả đặc tính, giới hạn của mô hình trong tháng 10.
Bình luận (0)